

経済産業省 廃炉・汚染水・処理水対策事業への参画
2026年6月18日、株式会社アイプランツ・システムズは、令和8年度「廃炉・汚染水・処理水対策事業費補助金(第三次)」における「過酷環境下の遠隔作業におけるフィジカルAIを搭載したロボット活用技術の開発」(代表事業者:株式会社クフウシャ)に参画いたします。
本事業は、株式会社クフウシャを中心に、国立研究開発法人日本原子力研究開発機構(JAEA)、東京大学大学院工学系研究科 趙研究室、株式会社EQUES(東京大学 松尾・岩澤研究室発スタートアップ)、株式会社デジラボホールディングス、株式会社アイプランツ・システムズが連携して取り組む共同研究開発事業です。
弊社はこれまで培ってきた、最新AIモデルの実装技術、点群・画像データからの3D環境モデル構築技術、ならびに放射線量分布を統合したデジタルツイン構築の実績を活かし、過酷環境下におけるロボットの自律化・高度化に向けたフィジカルAI技術の研究開発に貢献してまいります。
ロボット歩行の現状課題
Isaac Sim 付属の平地用歩行ポリシーを用いて、四足歩行ロボット SPOT を楢葉試験場の建屋データ上で歩かせました。建屋の床をクリックして歩行経路(開始点、チェックポイント、ゴール)を計画し、同じ経路を「がれきなし」「がれきあり」の 2 種類のデータで歩かせて、結果を比べています。がれきあり版は、障害物回避の強化学習使用を想定したデータです。
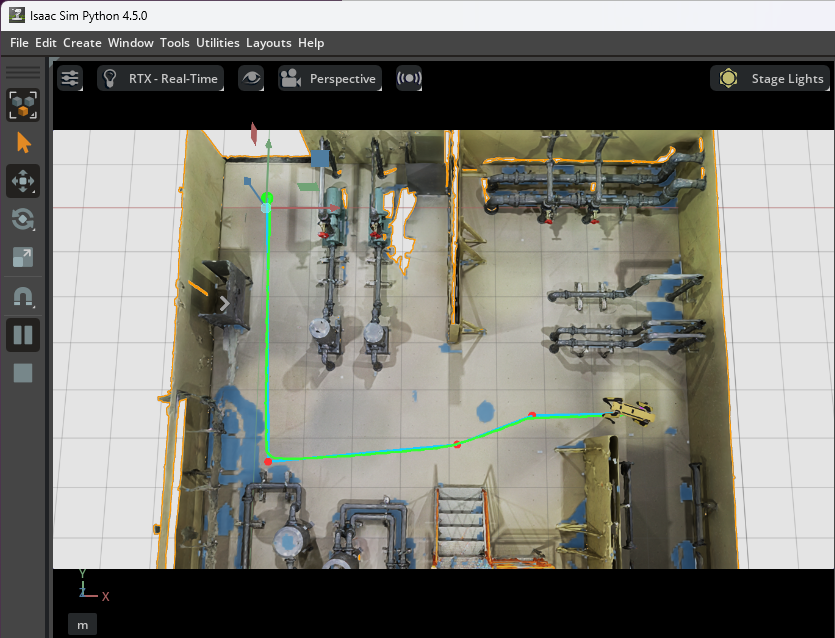
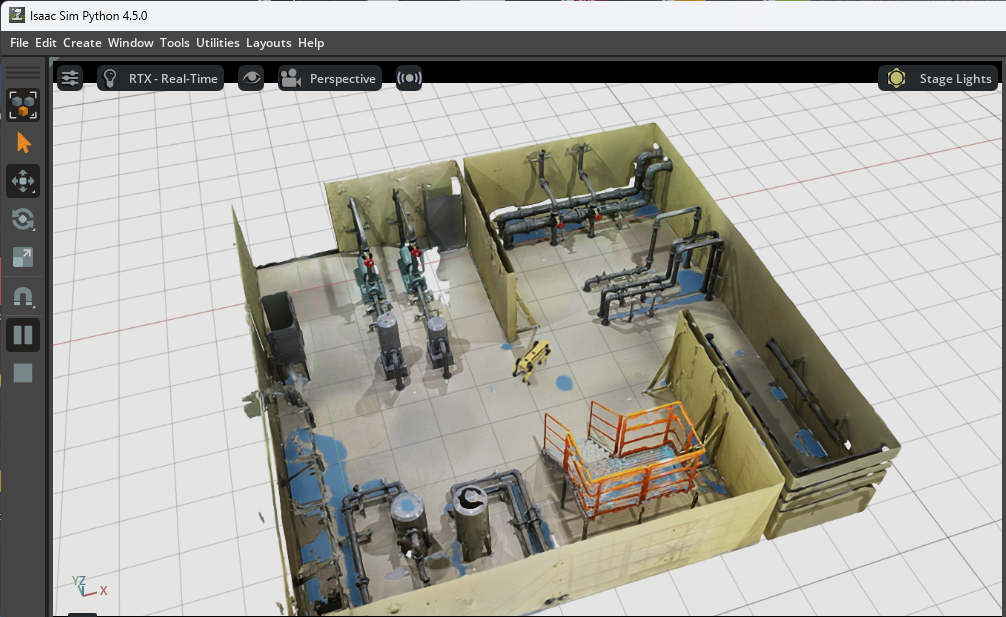
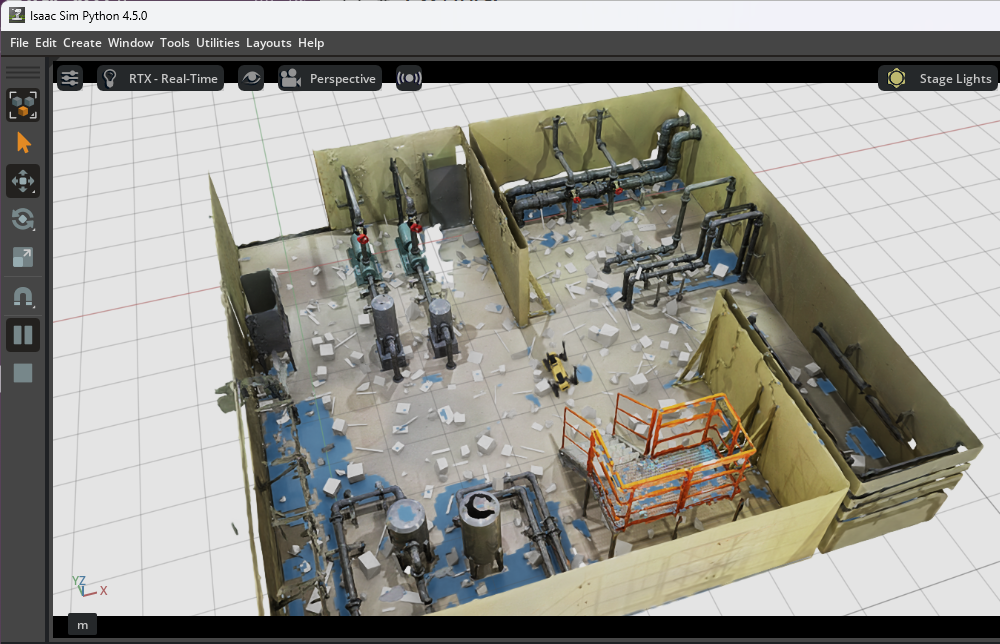
障害物のない床では、指定した経路どおりに歩けます。一方、がれきがあると、平地用の歩行ポリシーは足元の障害物を避けることも乗り越えることもできず、引っかかって止まります。がれきのある現場を歩くには、障害物を避けて歩く制御が必要です。この課題に対して、障害物回避を強化学習で獲得させた歩行のデモを紹介します。
動画の概要
四足歩行ロボットSPOTが、シミュレーション環境内で障害物を避けながら自律走行する様子を収録した約50分間の動画です。
SPOTは、機体に搭載された5組の深度カメラの情報だけを使って周囲を認識し、進む方向をリアルタイムに判断しています。走行経路は事前に設定しておらず、上空から見た俯瞰視点の環境情報も使用していません。
走行環境
楢葉試験場を模したシミュレーション環境を使用しています。この環境を5×5の合計25区画に複製し、さらに鏡像変換と対称変換を加えることで、走行範囲を広げるとともに環境の多様性を高めています。
制御のしくみ
SPOTの制御は、役割の異なる2つのモデルで構成しています。
- 歩行モデル:強化学習で獲得した基礎歩行ポリシーです。さまざまな地形での安定した歩行と姿勢の維持を担当します。横向きに転倒した場合は、自律的に起き上がることができます。
- 走行判断モデル(この動画で紹介するモデル):深度カメラの情報をもとに、移動する方向を判断します。
走行判断モデルは、CNN(畳み込みニューラルネットワーク)で5組の深度カメラ画像をそれぞれ処理し、各方向の環境の特徴を統合したうえで、移動指令を出力します。
移動指令は次の6種類です。「前進+左旋回」のように、組み合わせて同時に実行することもできます。
- 前進
- 後退
- 左方向への横移動
- 右方向への横移動
- 左旋回
- 右旋回
モデルの学習方法
人の操作を手本として学習し、その後、人による修正を繰り返し取り込む方法でモデルを改良しています。
- 初期データの収集:シミュレーション環境内でSPOTをキーボードで約1時間操作し、約6,000フレームのデータを収集しました。各フレームには、5組の深度カメラ画像と、その時点の操作指令が記録されています。
- 初期モデルの学習:収集したデータから、「現在の環境ではどの動作を選ぶべきか」を学習させました。
- 人による修正と微調整:学習したモデルでSPOTを自律走行させ、モデルが適切でない判断をした場面では、人がキーボード操作で介入して修正しました。この修正操作を新しい学習データとして記録し、モデルを微調整しました。
これまでに微調整を3回行っており、各回で約6,000フレームのデータを使用しています。この動画は、3回目の微調整を終えたモデルによる走行結果です。
この方式に至るまでの検討
現在の方式を採用するまでに、次の3つの方式を検討しました。
| 検討した方式 | 採用しなかった理由 |
|---|---|
| 周囲の空間を複数の扇形領域に分割し、各領域の障害物までの距離から移動方向を決める方式 | シミュレーション内の俯瞰情報に依存するため、実機への移行が難しい。扇形領域で表現できる環境情報にも限界があり、形状や配置の異なる障害物への対応が困難だった。 |
| 5組の深度カメラの情報をもとに、人が作成したルールで障害物を回避する方式 | 俯瞰情報は不要になったが、複雑な環境では空間的な関係が非常に多くなり、ルールだけですべての状況を網羅できなかった。 |
| 5組の深度カメラの情報から局所的なウェイポイント(経由点)をリアルタイムに生成し、SPOTを誘導する方式 | 環境の変化から動作の実行までに時間遅延があり、頻繁な方向修正が発生した。狭い場所で動けなくなりやすく、自律的な脱出も困難だった。 |
一方、6種類の移動指令を使ってSPOTをキーボードで操作したところ、非常に良好な制御性能が得られました。このことから、周囲の環境に応じてこれらの指令を正しく選択し組み合わせることができれば、人が操作する場合と同じように障害物を回避できると考え、現在の方式を採用しました。
その後の改良と今後の予定
動画の収録後、走行しながら学習を続けるためのしくみ(DAgger型の継続学習)をシステムに組み込みました。処理の流れは次のとおりです。
- 現在のモデルでSPOTを自律走行させる
- 不適切な判断が発生した場合、人がキーボードで介入する
- 深度カメラ画像と人による修正指令を自動的に記録する
- 走行終了時に、記録したデータを用いてモデルを微調整する
- 更新されたモデルで再び自律走行させる
これにより、モデルが走行中に遭遇した未知の状況や苦手な状況に対して、人が正しい動作を教え、その結果を次のモデルへ反映できるようになりました。DAgger(Dataset Aggregation)は、このように修正データを反復的に学習へ追加していく手法です。
今後は、一回ごとの走行を学習の機会として利用し、人の介入が必要な場面を段階的に減らしながら、自律走行と障害物回避の安定性を高めていきます。あわせて、実機のSPOTでの試験に向けた検討を進めます。